miércoles, 11 de septiembre de 2019

viernes, 12 de octubre de 2018
3 BASE DE DATOS DISTRIBUIDAS HETEROGÉNEAS
3.1 TIPO DE HETEROGENEIDADES
Los tipos de heterogeneidades en los sistemas de bases de datos pueden ser clasificadas
Bibliografia:
Laura Martínez M.. (2010). Ventajas de las BBDD en sistemas heterogéneos. Diseño y Construcción de BD Distribuidas Heterogéneas sobre Oracle y SQLSERVER(39). Madrid: Santillas.
Los tipos de heterogeneidades en los sistemas de bases de datos pueden ser clasificadas
en
- las debidas a las
diferencias en el SGBD
- las debidas a las
diferencias en la semántica de los datos.
La heterogeneidad
debida a la utilización de diversos SGBDs es común e organizaciones que crecen
sin una planificación en cuanto a sus sistemas de información. Dichos sistemas
evolucionan paulatinamente en diferentes SGBDs o diferentes modelos de
conceptualización tales como: jerárquico, de red, relacional u orientado a
objetos. Diferentes departamentos dentro de la empresa pueden tener requerimientos
diferentes y pueden seleccionar diferentes SGBDs. También los SGBDs adquiridos
a lo largo de un período de tiempo pueden ser diferentes debido a los cambios
en la tecnología. Cada SGBD tiene un modelo de datos subyacente utilizado para
definir estructuras de datos y las restricciones. Tanto los aspectos de
representación (estructura y restricciones) como de lenguaje pueden dar lugar a
la heterogeneidad.
Diferencias en la
estructura:
Diferentes modelos de
datos proporcionan diferentes primitivas estructurales. Pueden darse cuatro
tipos de conflictos: de tipo, de dependencia, de clave o de comportamiento.
Los conflictos de tipo
se producen cuando el mismo objeto es representado por un atributo en un
esquema y por una entidad en otro.
Los problemas de
dependencia se Diseñó y Construcción de Bases de Datos Distribuidas
Heterogéneas sobre Oracle Y SQL Server
producen cuando los
distintos modos de relación (por ejemplo, una relación uno a uno frente a una
de muchos a muchos) se usan para representar lo mismo en diferentes esquemas.
Los conflictos de clave se producen cuando existen varias claves candidatas disponibles
y se seleccionan claves primarias diferentes en distintos esquemas. Los
conflictos de
comportamiento están implícitos en los mecanismos de modelado. Por ejemplo,
borrar el último elemento de una BD puede provocar la eliminación de la entidad
que contiene (es decir, la eliminación del último empleado puede causar la
disolución del departamento). Si el contenido de la información no es el mismo,
puede ser muy difícil solventar las diferencias.
Diferencias en las
restricciones:
Dos modelos de datos
pueden soportar diferentes restricciones. Esto quiere decir que puede ser que
en un modelo de datos existan x tipos de restricciones y en otro modelo y,
que posiblemente sean diferentes. Los disparadores (o algún otro mecanismo)
deben ser utilizados en los sistemas relacionales para captar la semántica de
estos.
Diferencias en los
lenguajes de consulta:
Como por ejemplo cuando
se utilizan diferentes lenguajes de consulta para manipula los datos
representados en modelos de datos diferentes. Incluso cuando dos SGBDs se basan
en el mismo modelo de datos, las diferencias en los lenguajes de consulta (por ejemplo,
Quel1 y SQL) o las diferentes versiones de SQL soportado por dos SGBDs relacionales
pueden contribuir a la heterogeneidad.
Heterogeneidades debido a
diferencias semánticas
La heterogeneidad
semántica es un término bastante cargado, sin una definición clara. Básicamente
se refiere a las diferencias entre las BBDD que se relacionan con el significado,
la interpretación y el uso previsto de los datos. Sin duda, los aspectos más importantes
de la heterogeneidad semántica se revelan como conflictos de nombres. El
problema fundamental de
nombres es el de los sinónimos y los homónimos. Dos entidades idénticas que
tienen diferentes nombres son sinónimos, y dos entidades diferentes que tienen
nombres idénticos son homónimas. La detección de la heterogeneidad semántica es
un problema difícil. Normalmente, los esquemas de los SGBD no proporcionan la
semántica suficiente para interpretar los datos de forma coherente. La
heterogeneidad debida a diferencias en los modelos de
datos también
contribuye a la dificultad en la identificación y resolución de la heterogeneidad
semántica. También es difícil descomponer la heterogeneidad debida a diferencias
en el SGBD de los resultantes de la heterogeneidad semántica
Bibliografia:
Laura Martínez M.. (2010). Ventajas de las BBDD en sistemas heterogéneos. Diseño y Construcción de BD Distribuidas Heterogéneas sobre Oracle y SQLSERVER(39). Madrid: Santillas.
jueves, 11 de octubre de 2018
3.2 VENTAJAS DE LAS BBDD EN SISTEMAS HETEROGÉNEOS
La llegada de los sistemas
heterogéneos ha traído tanto beneficios como problemas. Las ventajas son por
supuesto muchas.
Bibliografia:
Laura Martínez M.. (2010). Ventajas de las BBDD en sistemas heterogéneos. Diseño y Construcción de BD Distribuidas Heterogéneas sobre Oracle y SQLSERVER(39). Madrid: Santillas.
- El tradicional procesamiento de los datos está siendo rápidamente reemplazado por la gestión de modernas BBD.
- Nuevas capacidades tales como la actualización en línea, consultas ad-hoc, y la integridad de los datos son fácilmente disponibles en SGBD modernos.
- Para todas las aplicaciones posibles de uso intensivo y grandes volúmenes de datos, existe un SGBD para la aplicación.
- Para una organización con diversas aplicaciones, un gran número de SGBD monomodelo y monolenguaje pueden ser utilizados para cada aplicación distinta.
Bibliografia:
Laura Martínez M.. (2010). Ventajas de las BBDD en sistemas heterogéneos. Diseño y Construcción de BD Distribuidas Heterogéneas sobre Oracle y SQLSERVER(39). Madrid: Santillas.
3.3 PROBLEMAS DE BBDD EN SISTEMAS HETEROGÉNEOS
Existen problemas que pueden
afectar a la eficacia y la eficiencia de la utilización de SGBD modernos en una
organización, como pueden ser:
- · Difícil intercambio, control y utilización global de datos. Si una organización tiene diferentes bases datos, con diferentes SGBD y diferentes modelos de datos, a la hora de acceder a la información es posible que los usuarios no sean expertos en diferentes modelos y SGBD. De hecho, lo general es encontrarse con profesionales en un modelo y en un lenguaje concreto.
- · Alto Coste de mantenimiento y soporte. Los SGBD heterogéneos en una gran organización tienden a ser muchos y sus BD de gran volumen, cada SGBD monomodelo y monolenguaje requiere el apoyo de un conjunto exclusivo de los ordenadores, un sistema separado de las unidades de disco, y un equipo dedicado de profesionales. Ya sea centralizado o distribuido, el conjunto de equipos, el sistema de discos, y el equipo de profesionales suponen una inversión importante y pesada para un SGBD monomodelo y monolenguaje. Como el número de estos SGBD monomodelo y monolenguaje aumentan, los gastos se multiplican. Además, los costos de la actualización de equipos, SGBD mejora del rendimiento, y la capacidad de crecimiento de la base de datos puede tener que ser multiplicada también. Desde el punto de vista de mantenimiento y actualización, siempre es más caro y requiere mayor esfuerzo mantener o actualizar los sistemas múltiples que actualizar un sistema único.
- · Las similitudes y la multiplicidad de SGBD heterogéneos. En resumen, los SGBD heterogéneos nos ofrecen soluciones informatizadas para aplicaciones de datos voluminosos e intensivos. En consecuencia, el procesamiento de los datos tradicionales y las nuevas aplicaciones de datos intensivos y voluminosos han llevado a la proliferación y la introducción de muchos SGBD monomodelo y monolingües. Si bien esta proliferación e introducción son gratificantes y probablemente continuarán, los SGBD monomodelos y monolingües, sin embargo, presentan nuevos problemas e introducen otras cuestiones. Estos problemas y cuestiones son intrínsecas a la similitud de SGBD monomodelo y monolingües. Son identificados como:
1.
El primer problema, en el intercambio global de
los datos, el control y la utilización es lo más fundamental, ya que impide que
el usuario de un SGBD monomodelo y monolingüe utilice las BBDD de otros SGBD
monomodelo y monolingües. En consecuencia, la carga se encuentra en la parte de
los usuarios que deben aprender los otros modelos y lenguajes para tener acceso
a otras BBDD y para la utilización de otros SGBD monomodelo y monolingües.
2.
El segundo problema es el coste. A medida que la
popularidad y la funcionalidad de los SGBD son cada vez más evidentes, el uso
de SGBD en una determinada organización se hará más frecuente. En consecuencia,
habrá muchos SGBDs heterogéneos en una organización. Como SGBDs separados,
monomodelos, y monolingües, que requieren apoyos por separado y hardware más
potente que soporte este tipo de sistemas, lo que se traduce en más costes.
BIBLIOGRAFIA
Laura Martínez M.. (2010). Problemas de BBDD en sistemas Heterogéneos. Diseño y Construcción de BD Distribuidas Heterogéneas sobre Oracle y SQLSERVER(40). Madrid: Santillas.
3.4 INTEGRACIÓN DE LAS BBDD.
La integración de BBDD
implica un proceso por el cual la información de las BBDD fragmentadas puede
ser conceptualmente integrada de forma coherente en una única BD.
La integración de BD puede darse en dos pasos:
· Esquema de traducción
·
Esquema de integración - Esquema de traducción.
El esquema de
traducción es la tarea de asignación de un esquema a otro. Los esquemas de los
componentes de BD se traducen en una representación canónica intermedia común
(InS1, InS2,...,InSn). El uso de una representación canónica facilita los
procesos de traducción por reducción del número de traductores que necesitan
ser escritos.
El paso de traducción
es necesario sólo si los componentes de BBDD son heterogéneos y cada esquema
local puede definirse mediante un modelo de datos diferente y aun así, puede no
ser necesario en una BD heterogénea, si puede llevarse a cabo durante la etapa
de integración.
- Esquema de integración.
El esquema de
integración es el proceso de identificación de los componentes de una BD que
están relacionados entre sí, de la selección de la mejor representación para el
ECG y, por último, de la integración de los componentes de cada esquema
intermedio. Dos componentes pueden estar relacionados como equivalentes, uno
está contenido en otro, o como disjunto.
Las metodologías de
integración pueden ser clasificadas como mecanismos binarios o n-arios.

Taxónomias de metodologías de
la integración
Las metodologías de
integración binarias implican la manipulación de dos esquemas a la vez.
Se puede producir
creando esquemas intermedios para la integración con los esquemas posteriores o
de una manera puramente binaria.

Métodos de integración binarios
Los mecanismos n-arios
de integración integran más de dos esquemas en cada iteración. Un paso de
integración se produce cuando todos los esquemas se integran a la vez,
produciendo el ECG después de una iteración.

Métodos de Integración n-aria
El mecanismo iterativo
n-ario de integración ofrece más flexibilidad y es más general (el número de
esquemas pueden variar en función de las preferencias de los integradores).
Los modelos binarios
son un caso especial de iterativos n-arios.
La integración de esquemas implica dos tareas:
· La homogeneización
· La integración
- Homogeneización
Durante esta fase, se
resuelven los problemas de la heterogeneidad semántica y de la heterogeneidad
estructural.
Respecto a la
heterogeneidad semántica, hay una serie de métodos alternativos para hacer
frente a los conflictos de nombres.
Respecto a la
heterogeneidad estructural, la transformación de las entidades y atributos / relaciones
entre unos y otros es una manera de manejar los conflictos estructurales.
Muestra los posibles
escenarios de transformación atómica. Las líneas punteadas indican que un
atributo dado es un identificador (clave) de la entidad asociada.

Alternativas
de Conformación Atómica
- Integración
La integración supone
la fusión de los esquemas intermedios y su reestructuración.
Todos los esquemas se
fusionan en un esquema de BD único y reestructurado para crear el
"mejor" esquema integrado. La fusión requiere que la información
contenida en los esquemas de participación se mantenga en el esquema integrado.
Bibliografía: Diseño y Construcción de Bases de Datos Distribuidas
Heterogéneas sobre Oracle Y SQL Server Páginas 41-44.
3.5 PROCESAMIENTO DE CONSULTAS EN BBDD HETEROGÉNEAS.
La naturaleza de los
sistemas que integran varias BBDD requiere pasos ligeramente diferentes a los
necesarios en el procesamiento de consultas distribuidas


Cada SGBD tiene sus propios procesadores de consulta y es más complejo
por las siguientes razones:
- La capacidad de los
componentes del SGBD pueden ser diferentes, lo que impide un tratamiento
uniforme de las consultas a través de múltiples SGBD y sitios.
- Del mismo modo, el coste de
tramitación de las consultas puede ser diferente en diferentes SGBD. Esto
aumenta la complejidad de las funciones de costes que deben ser evaluadas.
- Puede haber dificultades en
el movimiento de datos entre SGBDs ya que pueden diferir en su capacidad
para leer datos "movidos".
- La capacidad de optimización
local de cada SGBD puede ser muy diferente.
El SGBD heterogéneo,
recibe la consulta global. Cuando una consulta es recibida en un nodo, lo
primero que necesita hacer es “dividirla” en subconsultas basadas en la distribución
de datos a través de múltiples sitios. En este paso, sólo es necesario preocuparse
de la ubicación de los datos a través de los sitios, más que de su almacenamiento
a través de varias BDs.
La primera alternativa
consiste en descomponer una consulta global en el menor número de subconsultas
posible, cada una de ellas es ejecutada por un componente del SGBD.
Ventajas: La
descomposición es relativamente simple, y hay más oportunidades de optimización
en el nivel de consulta optimizador global.
Desventaja: El
procesador de consultas a nivel global y el optimizador hace más trabajo, y hay
más mensajes que se transmiten para ejecutar la consulta.
La segunda heurística
alternativa es descomponer la consulta global en el mayor número de subconsultas
posible, cada una de ellas es ejecutada por un SGBD.
Ventajas: el procesador
de consultas a nivel global y el optimizador hace menos trabajo, ya que entre
el espacio de procesamiento se reduce al mínimo.
Desventaja: Esto se
traduce en menos mensajes, pero en los procesadores de interfaz de componentes
más sofisticados (CIPS, component interface processors).
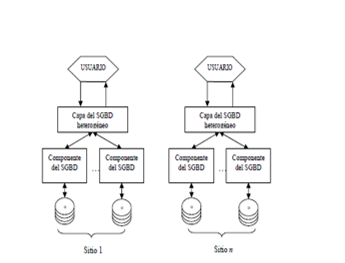
*Consulta global de múltiples bases
de datos en múltiples sitios*

*Estructura de un sistema
gestor de una base de datos distribuidas*
Bibliografia: Diseño y Construcción de Bases de Datos Distribuidas
Heterogéneas sobre Oracle Y SQL Server Página 45-47.
3.6 GESTIÓN DE TRANSACCIONES
3.6.1 Modelo de transacción
y computación.
La arquitectura de un SGBD
heterogéneo implica una serie de SGBDs, cada uno con su propio
administrador de transacciones (llamados gestores locales de transacciones o LTMs)
y una capa de SGBD heterogénea en la parte superior. El administrador de transacciones
de la capa del SGBD heterogénea de varios SGBD se llama administrador de
transacciones globales (GTM), ya que gestiona la ejecución de operaciones
globales.
En un sistema heterogéneo,
hay dos tipos de operaciones:
• Las transacciones
locales, que se envían a cada SGBD y se ejecutan en una única
BD
• Las transacciones
globales, que tienen acceso a múltiples BDs que se envían a la capa de
múltiples SGBD. Una transacción global se divide en una serie de subtransacciones
globales, cada una de los cuales se ejecuta en una BD.

3.6.2 Control de
concurrencia en sistemas heterogéneos.
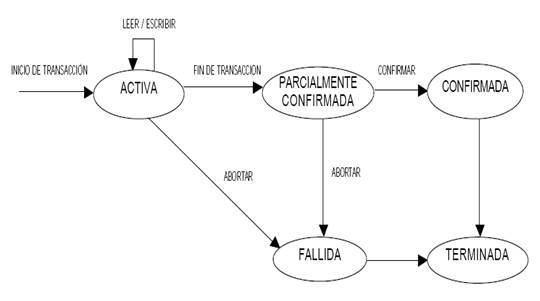
Dos transacciones son
conflictivas si tienen una operación que accede al mismo dato y al menos una de ellas es de escritura. No es sencillo para el
gestor de Transacciones Globales (TG) determinar los
conflictos en un sistema heterogéneo. Supóngase que dos transacciones globales que se manejan por el gestor de TG no
parecen estar en conflicto en absoluto. Sin
embargo, la existencia de transacciones locales puede provocar conflictos en los componentes de BD a través de
transacciones, los conflictos indirectos de este tipo no
pueden ser detectados por el gestor de TG y son un origen de dificultades significativas en múltiples SGBD.
Una serie de condiciones han
sido definidas para especificar cuándo se pueden actualizar las transacciones
globales de forma segura en un sistema heterogéneo. Estas condiciones son útiles para determinar la funcionalidad mínima
requerida de los diversos gestores de
transacciones.
• La primera condición para proporcionar el control de concurrencia global es que los DBA individuales sean responsables de la correcta ejecución de las operaciones en sus respectivas BBDD.
• La segunda condición
requiere que cada gestor local de transacciones (LTM) mantenga el orden de
ejecución relativa de las subtransacciones determinadas por el GTM. El GTM,
entonces, se encarga de coordinar la sumisión de las
subtransacciones globales al
LTM y la coordinación de su ejecución.
• Por otra parte, el
GTM es el responsable de tratar con interbloqueos globales que se producen en
las transacciones globales.
Bibliografia: Diseño y Construcción de Bases de Datos Distribuidas
Heterogéneas sobre Oracle Y SQL Server Página 48.
miércoles, 10 de octubre de 2018
3.7 HERRAMIENTAS UTILIZADAS
En este apartado se van a
introducir brevemente las herramientas principales utilizadas para el
desarrollo del proyecto.
El SGBD Oracle


Oracle es un SGBD relacional desarrollado por Oracle Corporation.
Se considera a Oracle como uno de los sistemas de bases de datos más
completos, destacando:
- Soporte
de transacciones,
- Estabilidad,
- Escalabilidad
- Soporte
multiplataforma
- Herramienta
cliente/servidor
Un SGBD relacional Oracle está compuesto por tres partes principales,
que son:
- El
kernel de Oracle
- Las
instancias del sistema de Base de Datos.
- Los archivos relacionados al sistema de Base de Datos.
El SGBD SQLServer


Microsoft SQL Server es un sistema para la gestión de bases de datos
producido por Microsoft basado en el modelo relacional. Sus lenguajes para consultas son
Transact-SQL y ANSI SQL. Microsoft SQL Server constituye la alternativa de
Microsoft a otros potentes SGBDs.
Las características de este SGBD son las siguientes:
- Soporte
de transacciones.
- Escalabilidad,
estabilidad y seguridad.
- Soporta
procedimientos almacenados.
- Incluye
también un potente entorno gráfico de administración, que permite el uso
de comandos DDL y DML gráficamente.
- Permite
trabajar en modo cliente-servidor, donde la información y datos se alojan
en el servidor y los terminales o clientes de la red sólo acceden a la
información.
- Además permite administrar información de otros servidores de datos.
Servidor Vinculado
Un servidor vinculado es una herramienta de SQL Server que permite
ejecutar comandos en orígenes de datos OLE DB situados en servidores
remotos. Los servidores vinculados ofrecen las siguientes ventajas:
- Acceso
al servidor remoto.
- Capacidad
de ejecutar consultas distribuidas, actualizaciones, comandos y
transacciones en orígenes de datos heterogéneos en toda la organización.
- Capacidad de tratar diferentes orígenes de datos de manera similar, como por ejemplo es el caso de SGBDD heterogéneos.
Componentes de servidores vinculados
Una definición de servidor vinculado especifica los siguientes objetos:
- Un
proveedor OLE DB
- Un
origen de datos OLE DB
Un proveedor OLE DB es una biblioteca DLL que administra un origen de
datos específico e interactúa con él. Un origen de datos OLE DB identifica la
base datos específica a la que se puede tener acceso mediante OLE DB. Aunque
los orígenes de datos en los que se realizan consultas a través de definiciones
de servidores vinculados son bases de datos normales, existen proveedores OLE
DB para una amplia variedad de archivos y formatos de archivo. Se trata de
archivos de texto, datos de hojas de cálculo y los resultados de búsquedas de
contenido de texto.
Database Link
Un enlace de base de datos es una herramienta de Oracle para conectar a
una BD remota a través de una BD local [3]. Los enlaces son útiles cuando se
desea consultar una tabla en una BDD, o incluso para insertar en una tabla
local datos localizados en otra tabla remota.
Existen tres tipos básicos de enlaces de base de datos: privados,
públicos y globales:
- Los
enlaces de tipo global tienen cobertura sobre toda una red y son los
utilizados por servidores de Oracle Names
- Un enlace de tipo privado pertenece al usuario que lo crea. La sintaxis de creación es la siguiente:

Donde:
- enlace_local es el nombre del enlace que se crea.
- xe es la cuenta a la que conectarse, en la base de
datos remota (nombre de usuario y contraseña).
- ‘remota.bd’ es el nombre global de la base de datos remota.
De esta forma el usuario conectará con la BD remota remota.bd usando el
nombre de usuario y contraseña de xen dicha BD. Para poder crear este enlace
privado, un usuario debe tener el privilegio de “crear enlace privado a base de
datos” en la BD local, así como el de “crear sesión” en la BD remota.
Tras la creación del enlace, el usuario responsable puede consultar las
tablas de xe en la base de datos remota remota.bd.
Bibliografia: Diseño y Construcción de Bases de Datos Distribuidas
Heterogéneas sobre Oracle Y SQL Server Páginas 50-52.
miércoles, 12 de septiembre de 2018
2 DISEÑO DE LAS BDD
2.1 DEFINICIONES
Álgebra relacional
Es un conjunto de operaciones que describen paso a paso cómo computar
una respuesta sobre las relaciones, tal y como éstas son definidas en el modelo
relacional.
Denominada de tipo procedimental.
Describe el aspecto de la manipulación de datos. Estas operaciones se
usan como una representación intermedia de una consulta a una base de datos y,
debido a sus propiedades algebraicas, sirven para obtener una versión más
optimizada y eficiente de dicha consulta.
Se van a explicar algunos operadores de álgebra relacional, que nos van
a ser necesarios para entender las reglas de fragmentación.
JOIN
La sentencia join en SQL permite combinar registros de dos o más tablas
en una base de datos relacional. Para hacer un join es necesario que exista un
campo que relacione los datos de cada tabla.
SEMI-JOIN
También conocida como semi-combinación. Opera de la misma manera que un
join, pero la relación resultante sólo tiene los atributos de la primera tabla.

Bibliográfia: Universidad Carlos III de Madrid, Pagina 20, Diseño
y Construccion de bases de datos distribuidas Heterogéneas sobre Oracle y SQL
Server.
2.2 ALTERNATIVAS DE DISEÑO
En
todo proceso de diseño hay dos aproximaciones básicas:

- La ascendente o Top-Down.
- La descendente o Bottom-Up.
El
diseño ascendente se utiliza, cuando se crea un BDD a partir de varias BBDD locales
existentes. Se parte de varios esquemas lógicos locales (ELL) con ubicaciones
diferentes que se integran en un único esquema lógico global (ELG).
El
diseño descendente parte de un ELG y construye varios ELL definidos a partir de esquemas
de fragmentación, asignación y replicación que determinan la distribución de los
datos en los distintos nodos de la red.
Bibliografia: Universidad Carlos III de Madrid, Pagina 21, Diseño
y Construccion de bases de datos distribuidas Heterogéneas sobre Oracle y SQL
Server.
2.3. FRAGMENTACIÓN
La fragmentación es un conjunto de técnicas para
dividir la BD en unidades lógicas, llamadas fragmentos, cuyo almacenamiento
puede asignarse a los diversos sitios. Estas técnicas se utilizan durante el
proceso de diseño de BDD. La información concerniente a la fragmentación de los
datos se almacena en un catálogo global del sistema al que tiene acceso el
software cliente cuando es necesario.
La fragmentación es un concepto que surge en los
modelos que incluyen algún tipo de particionado y tiene implicaciones físicas y
lógicas.
•
Fragmento lógico:
Bloque de datos localizado en algún SGBDD que puede ser descrito (en términos
relacionales) como el resultado de una proyección y/o una selección de la
información contenida en la BD, de modo que resulten subconjuntos disjuntos de
ella. Por tanto, una vez que la BD ha sido dividida en un conjunto de
fragmentos, todos los datos aparecen en uno y sólo uno de estos fragmentos
•
Fragmento físico: Subconjunto de un fragmento
lógico que se almacena completo en un nodo. Cada uno de los fragmentos físicos
de un fragmento lógico se localizan en uno o más nodos dependiendo del modelo
de distribución de los datos.
El esquema de fragmentación es el conjunto de las
distintas relaciones que se han obtenido del ELG y las condiciones empleadas
para esta división expresado en algebra relacional.
Existen distintas formas de fragmentar una relación:
Fragmentación
vertical
Fragmentación
horizontal
Fragmentación
mixta
Razones
para la fragmentación
Los esquemas de fragmentación se diseñan teniendo en
cuenta el uso que se va a hacer de los datos que se almacenan en cada una de
las sedes, construyendo relaciones más pequeñas y más adaptadas a las
operaciones de recuperación y actualización que utilizan las aplicaciones,
tratando así de aligerar las comunicaciones entre los nodos debido al alto
coste que éstas tienen.
Las cuatro razones para la fragmentación son las
siguientes:
Es útil ya
que las aplicaciones de BD suelen funcionar con vistas, y por ello se pueden
utilizar distintas relaciones en distintos nodos para formar la unidad
distribuida.
Se consigue
una mayor eficiencia dado que los datos suelen estar almacenados cerca del nodo
que más utiliza dichos datos.
Permite
aumentar el grado de concurrencia porque la fragmentación de las relaciones
permite que una transacción pueda dividirse en subconsultas que operan sobre
estos fragmentos.
Aporta una
mayor seguridad, dado que los datos no utilizados por un nodo local no se
almacenan en él y por lo tanto no están al alcance para personas sin
autorización.
Si las aplicaciones tienen requisitos conflictivos
que impiden la descomposición de la relación en fragmentos mutuamente
exclusivos, estas aplicaciones cuyas vistas se definen en más de un fragmento
pueden sufrir una degradación del rendimiento.
El segundo problema está relacionado con el control
semántico de los datos, especialmente para el control de integridad. Como
resultado de la fragmentación, los atributos que participan en una dependencia
pueden ser descompuestos en diferentes fragmentos que pueden ser asignados a
diferentes sitios. En este caso, incluso la simple tarea de comprobar las
dependencias daría lugar a la búsqueda de los datos en diferentes sitios.
Requisitos
de información
Uno de los aspectos del diseño de distribución es
que contribuyen demasiados factores para conseguir un diseño óptimo. La
organización lógica de la base de datos, la ubicación de las aplicaciones, las
características de las solicitudes de acceso a la base de datos, y las
propiedades de los sistemas informáticos en cada sitio tienen influencia sobre
las decisiones de distribución. Esto hace que sea muy complicado para formular
un problema de distribución.
La información necesaria para el diseño de la
distribución puede dividirse en cuatro categorías: información de la base de
datos, la aplicación de la información, información de la red de comunicación,
y sistema informático
Reglas
de fragmentación
Hay que tener en cuenta que la fragmentación podría
afectar al rendimiento del SGBDD, especialmente cuando se utilizan distintos
fragmentos ubicados en distintos nodos para construir una vista. También el
control de la semántica de los datos puede ser más complicado por la
fragmentación.
Para asegurar que la BD no sufrirá cambios
semánticos durante la fragmentación de los datos, se definen las siguientes
tres normas que determinen la calidad de la fragmentación de una relación :
Completitud: Sea R una relación descompuesta en fragmentos F(R)
= {R1, R2,…, Rn}. Entonces cada atributo de la relación deberá encontrarse en
al menos uno de los fragmentos Ri asegurando así que no hay pérdida de
información.
Reconstrucción: si una relación R se descomponen en fragmentos de
la forma R1, R2,.., Rn, debería ser posible definir un operador relacional ∇ tal que R = ∇ Ri para todo Ri
є FR (Fragmentos de R).
El operador ∇ será diferente
para cada forma de fragmentación; sin embargo es importante poder
identificarlo. Esta regla asegura que las restricciones de integridad
referencial están resguardadas.
Disyunción: si una relación R es fragmentada horizontalmente
en R1, R2,…, Rn, y el dato di está en Rj y solo en Rj. Esta regla asegura que
los fragmentos son disjuntos. Si se trata de una fragmentación vertical, sólo
los atributos clave deben estar repetidos en todos los fragmentos, de modo que
la propiedad disyunción se refiere únicamente a los restantes atributos
Fragmentación
vertical
La fragmentación vertical divide la relación
verticalmente en columnas, así cada fragmento mantiene ciertos atributos de la
relación original [2]. La fragmentación
se realiza mediante la operación PROYECCIÓN: ∏Li (R) donde i= 1...n y Ri es el
conjunto de fragmentos en que se divide la relación original. Li es el criterio
de fragmentación.
Para que la fragmentación vertical sea correcta los
subconjuntos de atributos Li han de cumplir:
·
La unión de todos los
Li contiene todos los atributos de la relación original.
·
La intersección de
todos los Li consiste en la clave primaria de la relación original. Todos los
Li tienen en común la clave primaria para poder reconstruir R mediante JOIN.

Suponiendo que en el campus de Getafe hubiera un
nodo de la BD y otro nodo se ubicara en el campus de Leganés, y que por ejemplo
el tratamiento y consulta de los datos personales se hiciera en el primer
campus y el concerniente a los datos académicos se hiciera en el segundo,
podría ser interesante realizar una fragmentación vertical en la que por un
lado estuvieran: - los datos personales con los campos “Nombre”, “Apellidos” y
“Edad” (L1). - y otra de datos académicos con los campos “Campus”, “Titulación”
y “Cursos” (L2).
Así, se podría almacenar una subrelación (fragmento)
en el campus de Getafe y otra en el campus de Leganés, quedando cada
subrelación de la siguiente manera:

Fragmentación
horizontal
La fragmentación horizontal divide la relación en
subconjuntos de tuplas, cada uno de ellos con un significado lógico.
La fragmentación se realiza mediante la operación
SELECCIÓN: σ Ci (R) Existen dos tipos de
fragmentación horizontal: primaria y derivada. En la Ilustración 3 se puede
observar un esquema de la fragmentación horizontal y en Ejemplo 2 un caso de
fragmentación horizontal de una tabla. - Primaria, es una selección de la
relación original. La fragmentación se
realiza mediante la operación Ri = σPi (R) donde Pi es un predicado sobre uno o
más atributos de R y es la condición empleada para seleccionar el contenido de
los fragmentos.
- Derivada, es una selección en función de
predicados definidos sobre atributos de otras relaciones o fragmentos; esto se
debe a que la relación R a fragmentar depende de la relación Q. Además, R hace
referencia a Q mediante una clave
ajena. La fragmentación se realiza mediante la
operación Ri = R Qi donde Qi corresponde al conjunto de
fragmentos en los que se ha dividido la relación Q.
Qi donde Qi corresponde al conjunto de
fragmentos en los que se ha dividido la relación Q.
La semicombinacion ( )
se hace por el atributo que relacionan estas dos tablas.
)
se hace por el atributo que relacionan estas dos tablas.
Podría ser interesante realizar una fragmentación
horizontal por el campo “Campus” y almacenar cada fragmento en cada uno de los
campus, suponiendo que en estos hubiera un nodo de la BD, quedando cada
subrelación de la siguiente manera:
ALUMNOS_LEG: Fragmento correspondiente a alumnos del
campus de Leganés (R1 = σ (CAMPUS =
Leganés))

Fragmentación
mixta o híbrida
La fragmentación mixta es la mezcla de fragmentación
horizontal y vertical. Hay dos tipos de fragmentación mixta
·
Fragmentación VH Es
una fragmentación vertical seguida de una fragmentación horizontal, sobre cada
uno de los fragmentos verticales.

Ejemplo 3 fragmentación vertical-horizontal
En la
siguiente relación ALUMNOS (R)

Podría ser interesante realizar una fragmentación
vertical en la que se particionaran - los datos personales con los campos
“Nombre”, “Apellidos” y “Edad” (FV1) - los datos académicos con los campos
“Campus”, “Titulación” y “Cursos” (FV2) Seguida de una fragmentación horizontal
por el campo “Campus”.
De este modo se obtendrían los siguientes
fragmentos…. Datos personales (FV1) del
Campus Leganés (FV1H1), Campus Getafe (FV1H2) y Campus Colmenarejo (FV1H3) y datos académicos (FV2) del Campus Leganés (FV2H1), Campus
Getafe (FV2H2) y Campus Colmenarejo (FV2H3).
- ·
Fragmentación HV Es
una fragmentación horizontal seguida de una fragmentaciónvertical, sobre cada
uno de los fragmentos horizontales.


En la relación ALUMNOS podría ser interesante
realizar una fragmentación vertical por el campo “Campus” Campus de Leganés (FH1) Campus de Getafe
(FH2) Campus de Colmenarejo (FH3)
Seguida de una fragmentación vertical (V1) en la que
por un lado estuvieran - los datos
personales con los campos “Nombre”, “Apellidos” y “Edad” (campus de Leganés FH1V1, campus Getafe FH2V1
y campus Colmenarejo FH3V1) - y otra
(V2) de datos académicos con los campos “Campus”, “Titulación” y “Cursos”
(campus de Leganés FH1V2, campus Getafe FH2V2 y
campus Colmenarejo FH3V2).
Suscribirse a:
Entradas (Atom)